2026年10月29日,国科智安(北京)科技有限公司(以下称国科智安)联合北京前瞻人工智能安全与治理研究院(以下称前瞻院),正式推出SSAI智盾V1.5产品矩阵。该产品矩阵覆盖网络安全攻防、大模型评测、内容鉴伪、AI安全智能体应用多个领域,搭建起“以AI治理AI”的人工智能安全底座。
AI安全风险加速演进,智盾构建新型安全基础设施
当前,人工智能安全风险正成为全球行业关注的重点。2026年,多家头部人工智能企业的模型在测试过程中出现自主突破隔离环境、入侵真实系统等越界行为,AI安全风险关注点已经从模型“说了什么”转向“做了什么”。
针对这一行业现状,国科智安与前瞻院携手推出SSAI智盾系列产品。产品立足AI原生安全,聚焦智能体与系统安全,以人工智能全生命周期安全治理为主线,意在打造面向人工智能时代的新型安全基础设施。
同时,该系列产品面向AI全生命周期,构建起涵盖数据安全、模型内生安全、智能体安全、具身智能安全的一体化防护治理体系,保障人工智能系统实现可信、可控、可测、可审计。
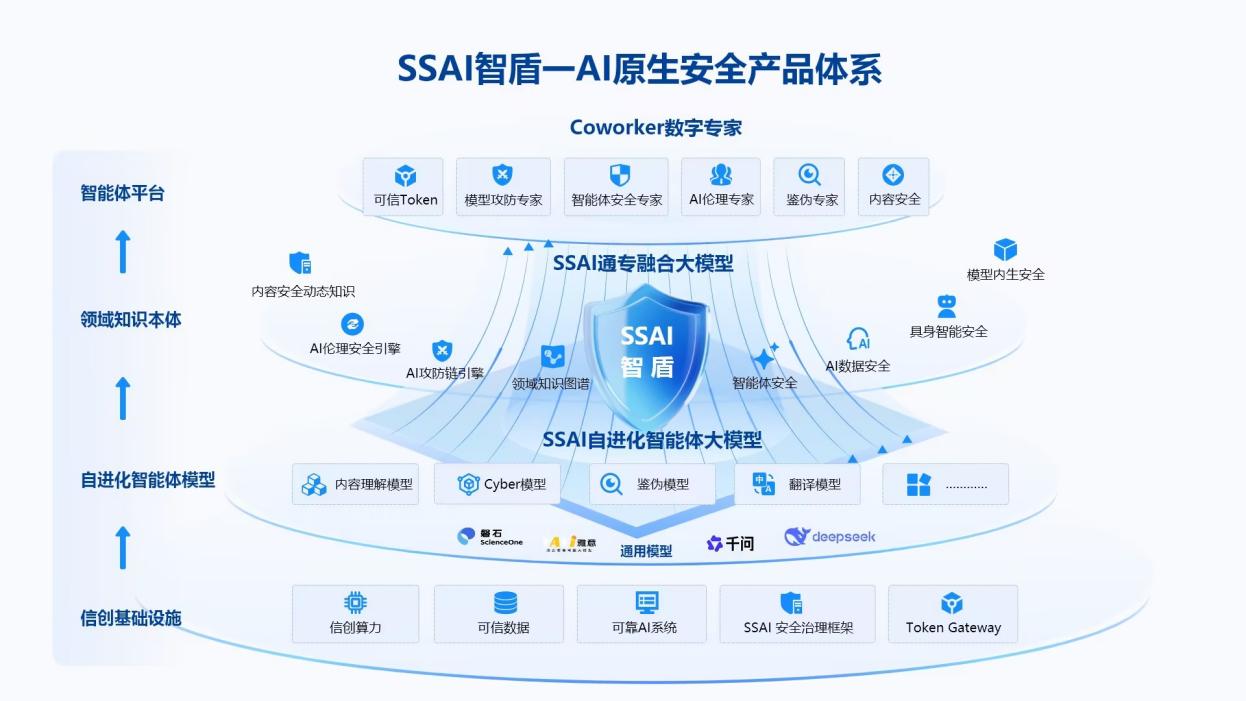
图:智盾产品框架示意图
智盾Cyber网络安全攻防大模型:打造攻防一体的能力底座
目前主流AI赋能网络攻防的实现路径主要为:依托通用大模型搭配安全领域智能体框架,依靠人工经验设计专项任务流程或者安全领域知识库。该模式存在明显短板:一方面网络安全任务类型繁杂,定制化智能体架构难以实现动态适配;另一方面通用大模型本身在安全领域专业能力不足。
智盾Cyber网络安全攻防大模型对此提出解决方案:将攻击任务能力与工具进行技能化处理,搭建大规模网络安全长程任务环境并采集求解轨迹,采用模型-智能体联合训练方式完成领域大模型的构建,把攻防工具、攻防技能、真实攻防过程转化为模型可学习、可持续迭代的能力。新版本的智盾模型可进一步对通用大模型形成替代,适配不同类型智能体与安全任务,完成模型迭代更新。
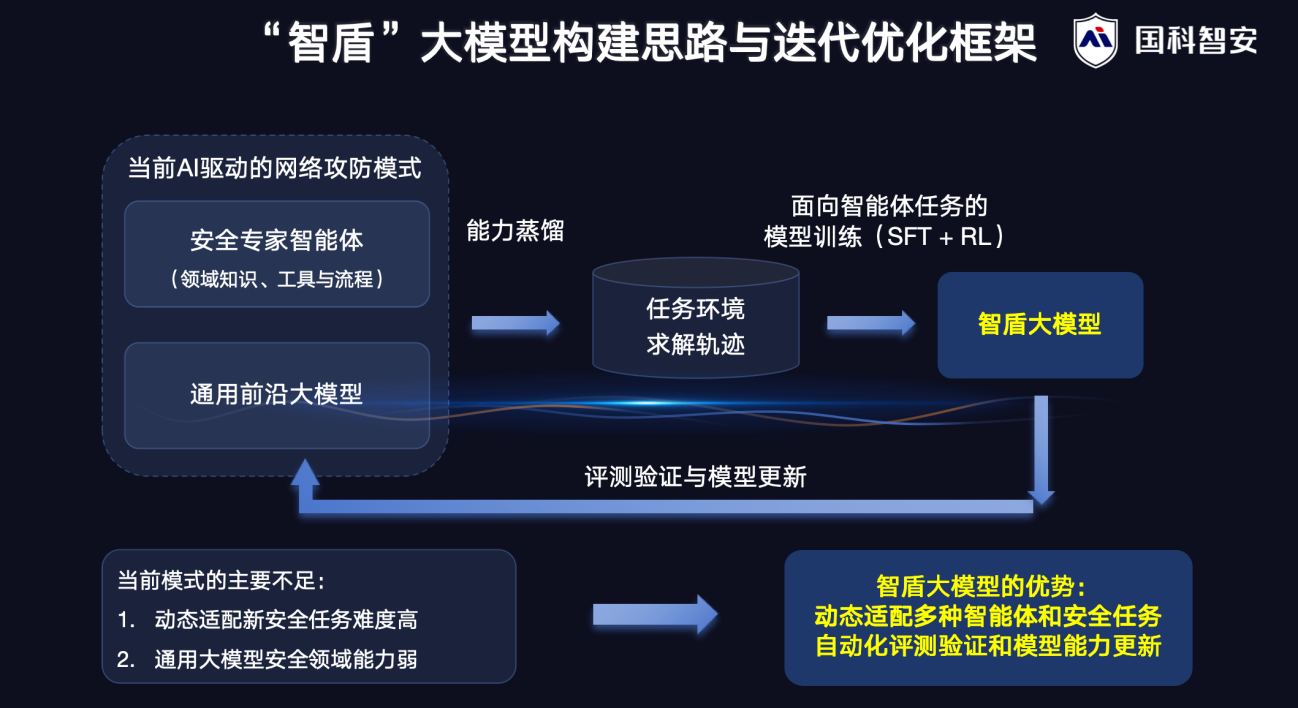
图:智盾Cyber大模型构建框架
智盾大模型采用指令监督微调、在线策略蒸馏、智能体强化学习三阶段训练流程,持续提升攻防综合能力。据初步评测数据,智盾大模型在典型的网络安全评测数据集XBow、PatchEval上的性能相对于基座模型取得了显著提升。依托该智盾大模型,搭建国科智安自研的攻防智能体框架,可落地网络攻防、日志分析、代码审计等应用场景。
攻防平台搭建三层安全防线 AIGC内容鉴别内容真伪
本次发布会,国科智安与前瞻院还联合推出了智盾人工智能攻防平台、智盾AIGC内容鉴伪和智盾Coworks数字专家平台等重磅产品。
智盾人工智能攻防平台搭建起模型、对话、Agent三层防线,分别回应“能不能上线、该不该放行、是不是安全”三大核心问题。
据了解,该平台的模型层配置5大评测模式,采用“盲盒+黑盒”双轨评测体系,支持一次性接入多家厂商大模型;合规性评测设置12维独立评分体系,相关能力已经在12个垂直行业完成落地。对话层针对编码绕过、越狱、多轮诱导等攻击手段具备较强防御鲁棒性。Agent层可覆盖7大类41个子类代码风险,安全权重占比70%,一旦命中阻断项将直接触发安全门禁。
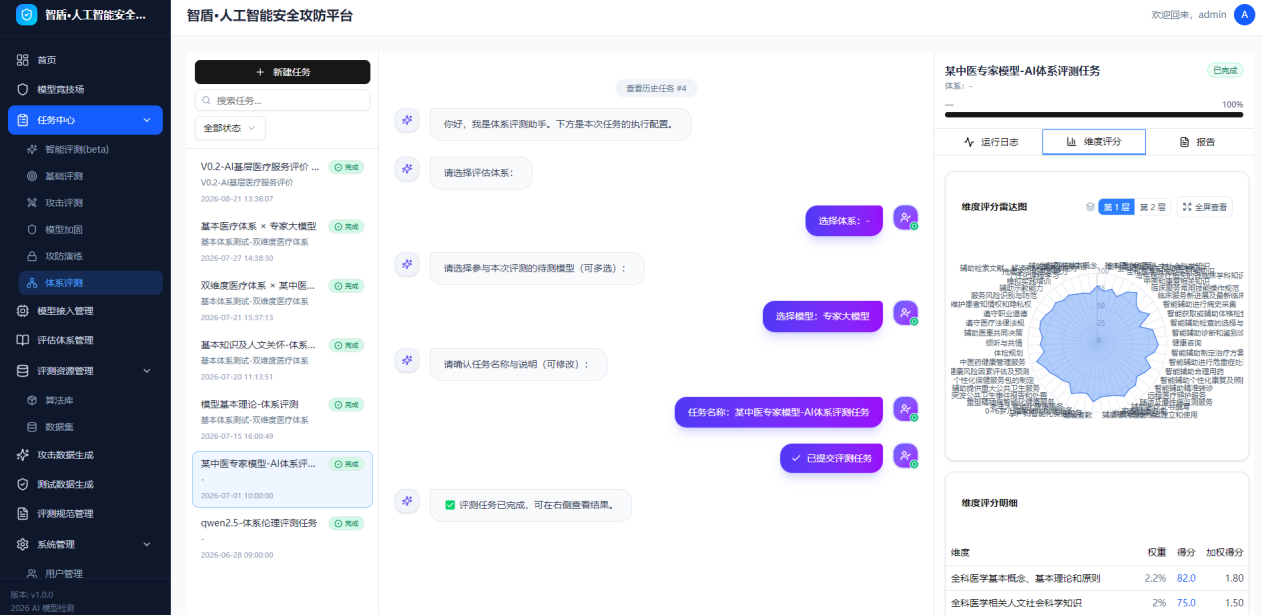
图:智盾人工智能攻防平台能力全景图
针对文字、图片、视频、语音多模态内容可信性核验需求,新推出的智盾AIGC内容鉴伪产品,既能够完成事实核验,也可识别AI生成痕迹。平台摒弃单一模型判别思路,采用多视角独立分析,经过两层评议输出最终鉴伪结论。
测试数据显示,该平台伪造风险识别准确率87.18%,误导风险识别准确率84.62%,AIGC生成检测平均正确率96.88%,AI来源溯源平均正确率94.91%,产品可覆盖88类主流AIGC模型与生成器生态。
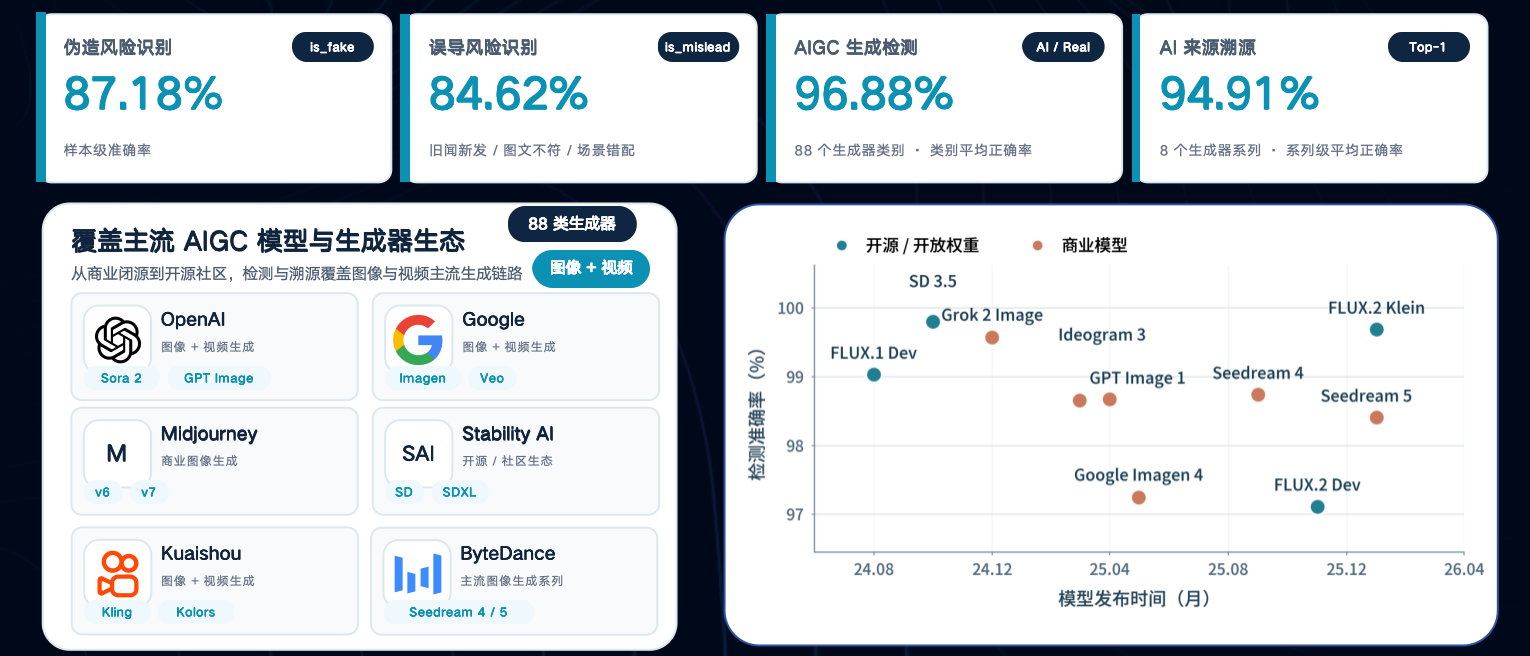
图:智盾AIGC内容鉴伪核验流程
此外,新推出的智盾Coworks数字专家平台定位为政企级可信数字专家智能体平台,会话全程留痕,业务过程可回溯。用户通过自然语言指令即可发起任务,例如输入“创建一个评测任务”,平台将自动完成模型匹配、攻击方式选择、法规标准参照,自动执行任务并输出分析报告。该平台内置8个以上领域专家角色,具备100余项专项技能。业务拓展无需重新搭建整套系统,通过新增专家角色、挂载对应技能,即可快速拓展全新业务方向。
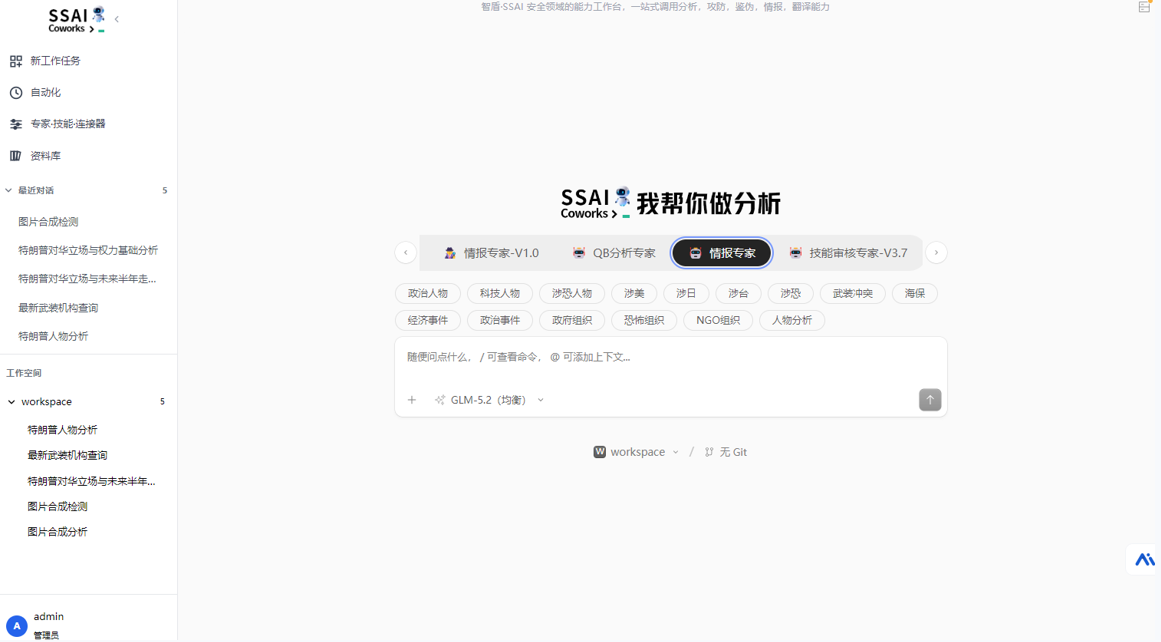
图:智盾Coworks数字专家平台
推动伦理审查工程化落地,破解AI治理现实困境
本次发布会上,北京前瞻院AI伦理研究中心主任范津宇就人工智能伦理审查落地路径开展主题分享。
范津宇提出,当前人工智能伦理治理已经形成全球共识,伦理审查正在从倡导性要求转向强制性合规义务,但落地实践仍面临三重现实困境:伦理原则易于确立,量化度量难以落地;人工审查周期往往超过一个月,而大模型迭代周期以周为单位;风险多为事后发现,难以做到事前防范。
范津宇表示,前瞻院将审查维度凝练为人类福祉、公平公正、可控可信、透明可解释、责任可追溯、隐私保护六大方向,把抽象AI伦理风险具象化;同时联合产业界拆解细化为90余项子评测维度,推动伦理风险从原则概念转化为可落地的工程化评测流程。
当前有研究表明,大模型存在“对齐伪造”现象:在知晓自身处于被监督,以及无监督两种场景之下,模型拒绝有害请求的比例差距超过10个百分点,一次性静态评测结论会随着模型能力迭代失效,伦理评测需要保持动态演进。范津宇表示,国科智安与前瞻院的战略合作以及本次发布的智盾系列产品,正是伦理评测能力工具化的重要实践。(中国经济网记者 黄春棉)
(责任编辑:许子杰)